Dei autonomia aos meus agentes de IA sem perder o controle
Enquanto escrevo este post, alguns agentes estão trabalhando em um computador de aproximadamente 2013.
Ele tem um Intel Core i7-4770, 8 GB de RAM DDR3 e alguns discos reaproveitados. Para quem não é da área, é como um carro de 2013 que já rodou 600 mil km e continua funcionando: tem alguns cavalos a menos, mas ainda cumpre o seu papel.
Do outro lado está meu notebook principal: um Dell G15 com i7-13650HX, 32 GB de RAM DDR5 e RTX 3050. É um esportivo de 2025 que rodou 100 mil km e está com a manutenção em dia.
Se a decisão fosse baseada apenas em desempenho, obviamente tudo estaria rodando no notebook.
Mas hoje as duas máquinas cumprem papéis bem diferentes.
Meu notebook continua sendo onde faz sentido executar tarefas que realmente precisam de potência local: compilações Android, reverse engineering, algumas cargas mais pesadas, além de tudo que não tem relação com IA — faculdade, jogos e uso pessoal.
O servidor ficou com outra função. É onde eu piloto agentes. E isso só começou a fazer sentido de verdade quando o Orca entrou na arquitetura.
Um servidor que começou bem mais simples
A ideia inicial era só tirar ambientes de teste da minha máquina principal.
PostgreSQL, MySQL, Node.js, APIs, containers, pequenos projetos e integrações que não precisavam ocupar o mesmo ambiente que eu usava no dia a dia.
O ganho era simples: eu podia destruir um ambiente, subir outro, testar uma integração e não transformar meu notebook em um depósito permanente de serviços.
O Orca é o orquestrador open source que adotei para controlar os agentes e suas atividades. Antes dele, no notebook, eu já utilizava o Maestri. A partir do Orca, aquela máquina deixou de ser apenas um lugar onde serviços ficavam rodando e passou a ser o lugar onde os agentes efetivamente trabalhavam.
Foi aí que o servidor ganhou uma função muito mais clara.
E 8 GB de RAM são suficientes?
Surpreendentemente, para esse uso, sim. Porque eu não estou rodando modelos de IA localmente.
Não existe um Llama gigantesco ocupando dezenas de gigabytes de memória, nem uma GPU trabalhando para fazer inferência. Os modelos continuam fora da máquina.
O servidor executa os agentes, seus processos, ferramentas, workspaces, browsers, bancos e serviços auxiliares. Isso é bem diferente.
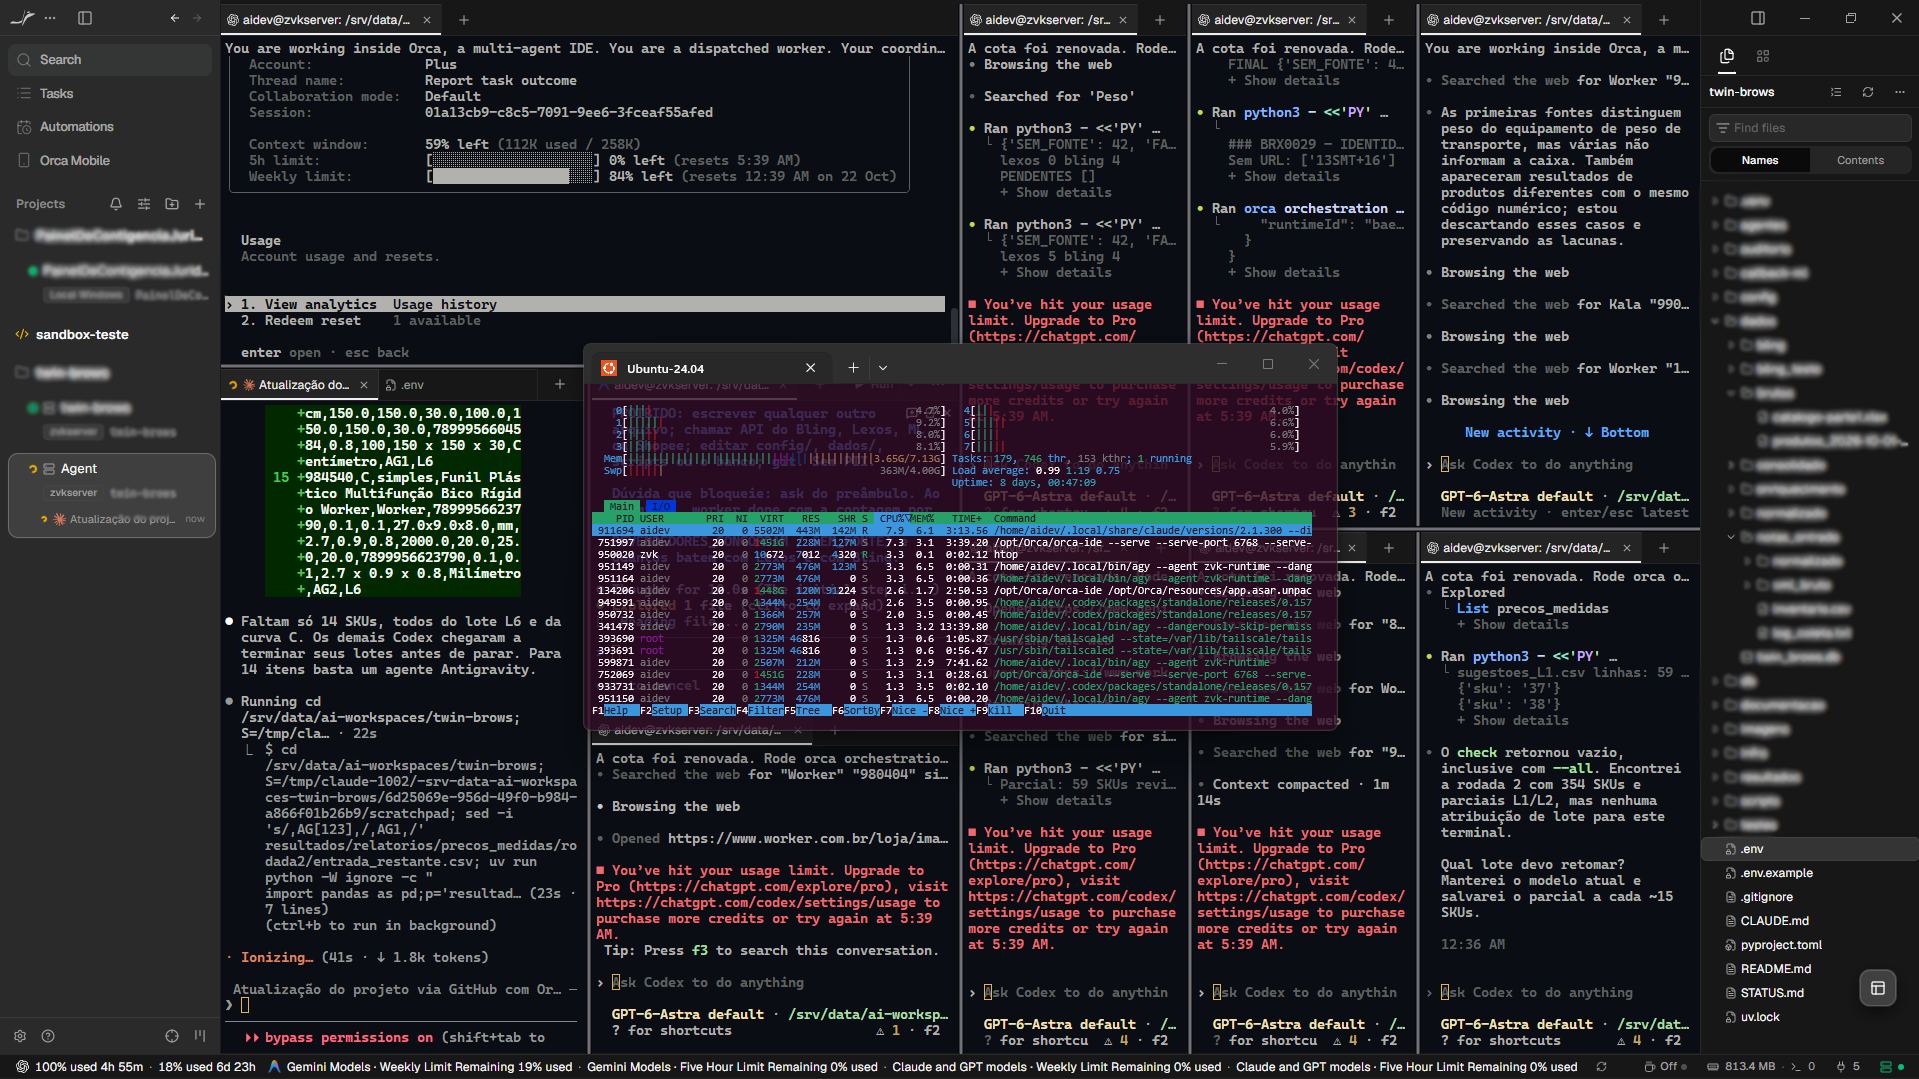
Com Ubuntu Server e sem uma interface gráfica pesada, 8 GB de RAM conseguem atender muito bem esse cenário até agora. E acho que esse é um ponto interessante do projeto.
Você não precisa necessariamente de um servidor caro ou de uma workstation com uma GPU gigantesca para começar a trabalhar com uma infraestrutura de agentes.
Se a inferência está sendo feita por um provedor de LLM externo, o servidor está principalmente coordenando execução. O que passa a importar muito mais é organização, isolamento e controle.
O problema que eu queria resolver não era performance
Eu já usava agentes com bastante autonomia em projetos reais. Eles editavam código, executavam testes, investigavam bugs, preparavam ambientes e avançavam tarefas praticamente sozinhos.
Até os projetos começarem a se misturar. Um handoff carregava decisões de outra sessão.
Um agente trabalhando em um teste conseguia enxergar código de outro projeto.
Um projeto novo começava a nascer com padrões de outro simplesmente porque aquele contexto ainda estava presente. Nada disso precisava acontecer de forma obviamente errada.
O resultado podia funcionar. Mas eu começava a perder clareza sobre de onde determinadas decisões estavam vindo. É quase como viciar o harness da IA.
Aos poucos, o ambiente acumula contexto, ferramentas, padrões e decisões até o agente começar a trabalhar baseado em uma mistura de tudo aquilo.
Para testes pequenos, talvez não seja tão grave. Para projeto real, eu não gosto dessa ideia.
Agentes autônomos são excelentes exatamente porque não precisam perguntar tudo. Mas autonomia não significa abandonar a pilotagem. Eu quero conseguir deixar o agente dirigir e ainda saber se ele continua dentro da estrada.
A fronteira precisava existir fora do prompt
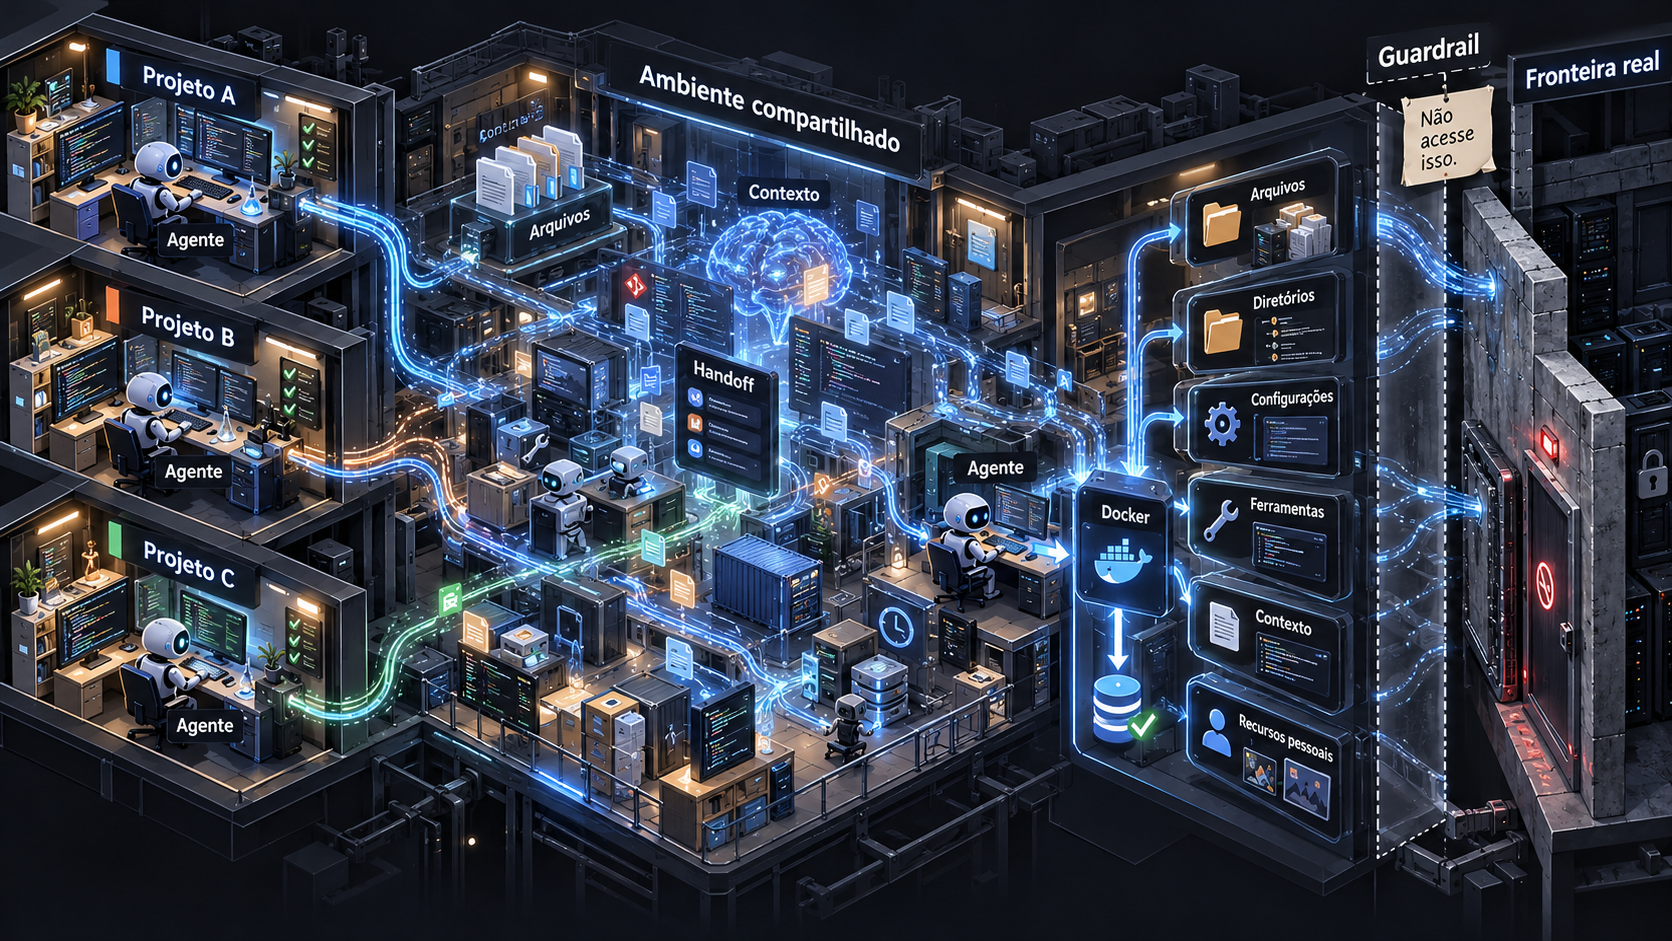
Os projetos já tinham regras e guardrails. Mesmo assim, uma coisa continuava me incomodando: o agente tecnicamente conseguia alcançar mais coisas do que deveria.
Em uma situação, por exemplo, ele precisava validar uma alteração e simplesmente subiu um banco em Docker. Resolveu o problema. Só que aquilo levantou uma questão melhor:
Se ele consegue iniciar um container, ler arquivos e decisões de outros projetos, o que mais da máquina também está disponível? Quais arquivos pessoais estariam disponíveis para se misturarem ao contexto da sessão?
Eu não queria depender apenas de uma instrução dizendo:
Não mexa nisso.
Eu queria que o agente simplesmente não conseguisse mexer.
Um ambiente por projeto
Hoje cada projeto fica muito mais delimitado. Workspace próprio. Contexto próprio. Git próprio.
E os provedores de LLM — Codex, Antigravity e Claude — executam dentro de um ai-jail.
Na prática, o ai-jail funciona como uma área cercada para o agente: ele consegue trabalhar normalmente dentro daquele espaço, mas não pode simplesmente sair explorando arquivos, comandos e recursos do restante da máquina.
Essa separação também conversa bastante com a filosofia do próprio Orca.
A proposta dele não é tratar um agente como apenas mais um terminal aberto dentro de um editor. O ambiente foi pensado em volta dos agentes: workers paralelos, worktrees separados e uma interface que os próprios agentes conseguem operar.
O que adicionei por cima foi uma fronteira mais rígida para o meu cenário: além de separar o trabalho, eu também queria controlar o que cada agente consegue alcançar no host.
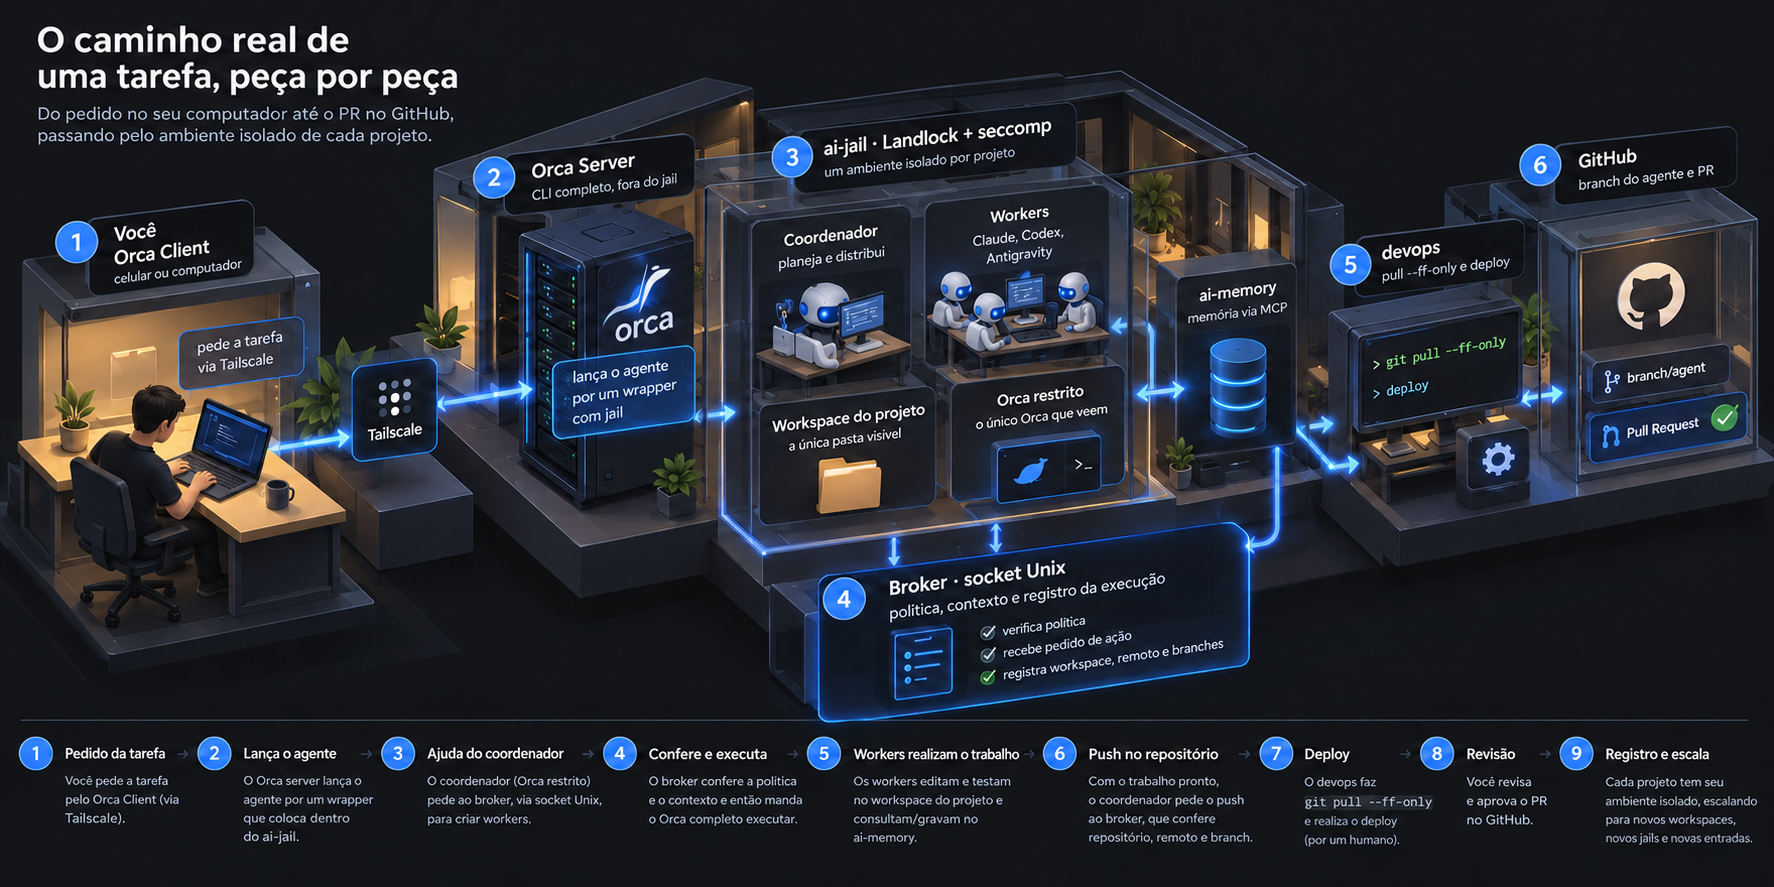
O caminho completo de uma tarefa, do pedido até o pull request, ficou assim:
O agente vê o que precisa para trabalhar naquele projeto. Quando precisa tocar alguma coisa fora desse espaço, pede uma operação ao broker. Isso permite trabalhar com uma ideia que passei a gostar bastante:
capacidade específica em vez de acesso genérico.
Se um agente precisa fazer git push, ele não precisa receber uma chave SSH. Ele precisa conseguir solicitar um push. O broker valida projeto, workspace, branch, remoto e contexto. Se tudo estiver correto, executa do lado do host.
A credencial não entra no jail.
Contexto também precisa de isolamento
Depois apareceu outro problema. Workers podem ser descartáveis. O conhecimento do projeto não deveria ser.
Uma sessão pode conter horas de contexto: regras de negócio, decisões, tentativas que falharam, exceções descobertas durante uma investigação.
Se tudo desaparece quando o worker termina, o próximo agente começa mais burro. Foi aí que o ai-memory entrou na arquitetura. O contexto pode continuar existindo fora do ciclo de vida daquele agente. O Codex registra algo, o Claude Code recupera depois.
A memória passa a pertencer ao projeto, não necessariamente ao chat ou ao modelo que criou aquela informação. Mas isso também precisa de limites.
Eu gosto da comparação com massinha de modelar. Cada cor separada funciona muito bem.
Misture todas e, depois de algum tempo, você termina com uma massa cinza onde ninguém sabe mais de onde veio cada coisa.
Contexto funciona do mesmo jeito. Uma decisão de um projeto não deveria aparecer automaticamente em outro. Uma regra de um cliente não pode contaminar outro contexto.
Hoje essa separação existe por projeto e workspace.
O acesso mobile fechou o ciclo
Uma das vantagens mais úteis de ter essa infraestrutura separada é ela continuar existindo quando eu fecho o notebook. Os workspaces continuam lá. Os serviços continuam configurados. O contexto continua disponível.
E os agentes podem continuar trabalhando. Pela rede privada consigo acessar o servidor pelo celular, iniciar tarefas e acompanhar execuções.
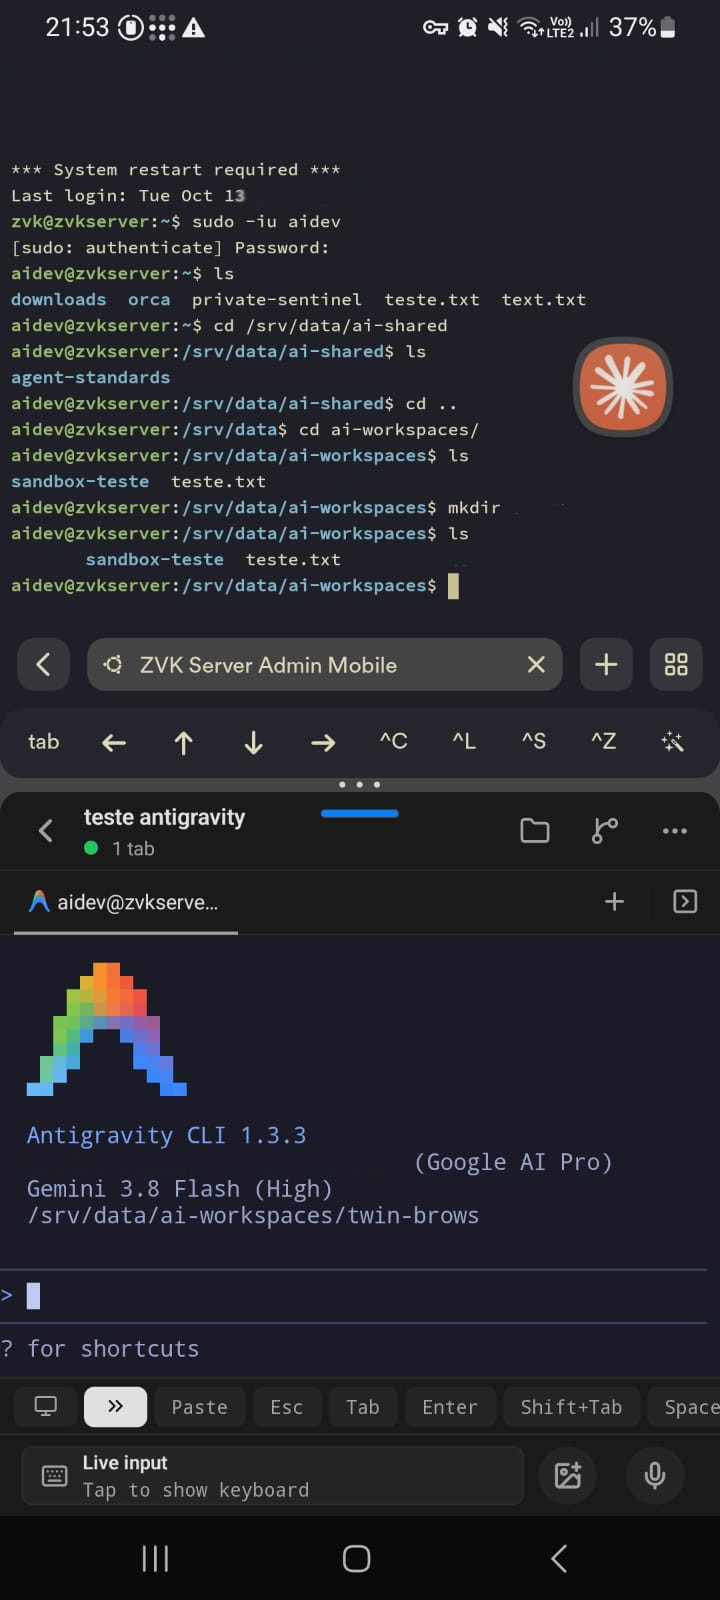
No trabalho presencial isso começa a abrir possibilidades bem interessantes.
Uma reunião pode gerar uma transcrição e essa transcrição seguir para o contexto daquele projeto.
O agente já pode separar decisões, levantar pendências, montar tarefas ou começar um relatório antes de eu voltar para a mesa.
Claro que isso depende de consentimento, confidencialidade e das regras do ambiente onde você trabalha. Mas, quando esse fluxo é permitido, a redução entre informação e execução é enorme.
O servidor não é apenas uma máquina remota.
Ele virou um ambiente de trabalho que continua disponível mesmo quando minha máquina pessoal está fazendo outra coisa.
O modelo virou uma peça substituível
A memória desacoplada também reduz a dependência de um provedor específico. Ou seja, me dá liberdade de testar mais LLMs com a memória gerada por outros modelos mais refinados.
Com o Orca eu posso executar a mesma tarefa com três agentes diferentes trabalhando em worktrees diferentes. Seja para comparar os resultados entregues, sem depender de benchmark de outras pessoas.
Eu não quero que a função do agente esteja presa ao modelo. A estrutura que venho usando separa mais ou menos assim:
Role        -> pelo que o agente responde
Skill       -> como executa o trabalho
Capability  -> o que o runtime permite
Provider    -> qual modelo executa
Se amanhã um provedor de LLM ficar caro, mudar de comportamento ou simplesmente ser sancionado por um estado maior, consigo trocar essa peça sem jogar fora o restante. Sou dono do meu contexto sem depender da boa vontade do provedor.
E se essa máquina antiga morrer?
Essa pergunta ficou inevitável quando comecei a tratar contexto como algo persistente. Não fazia sentido defender que memória é um ativo e deixar tudo preso em discos antigos.
Hoje os dados relevantes passam por backup criptografado, com cópia local e outra fora do servidor.
Você precisa montar algo assim?
Provavelmente não. E acho que esse também é um ponto importante.
Essa arquitetura resolveu problemas que começaram a aparecer no meu fluxo de trabalho.
Eu uso vários agentes. Trabalho em vários projetos diferentes.
Quero preservar contexto.
Quero acessar esses agentes fora da minha máquina.
E principalmente quero conseguir dar bastante autonomia sem perder completamente o controle das fronteiras.
Se você usa um único agente de vez em quando para corrigir código ou gerar uma função, montar tudo isso provavelmente seria apenas complexidade desnecessária.
Mas se o agente começa a virar parte permanente da sua rotina, talvez faça sentido pensar menos em “qual modelo estou usando?” e mais em:
- onde ele está executando;
- o que ele consegue acessar;
- qual contexto pertence a cada projeto;
- onde esse contexto fica guardado;
- quem pode executar determinadas ações;
- e o que acontece quando você troca de provedor.
Foi esse conjunto de perguntas que fez o servidor valer a pena para mim.
136 commits depois
Entre 10 e 25 de outubro, o repositório de infraestrutura acumulou 136 commits.
A máquina continua sendo um computador de 2013 com 8 GB de RAM.
Não estou rodando modelos locais. Não existe nenhuma GPU especial ali.
O que existe é uma máquina pequena, sempre disponível, com Linux, algumas boas práticas de isolamento e uma camada de orquestração em cima.
E talvez esse seja um dos pontos mais interessantes de tudo isso.
Para orquestrar agentes você não precisa necessariamente de uma máquina absurda.
Precisa de hardware suficiente para o workload que está executando e, principalmente, de uma arquitetura que faça sentido para o nível de autonomia que pretende entregar.
No meu caso, separar essa infraestrutura trouxe mais valor do que simplesmente colocar mais potência na mesma máquina.
Ainda tenho várias coisas para resolver: identidade forte entre agentes, isolamento de browser, auditoria e reconstrução automática do host continuam na lista.
Mas a ideia central já está bem definida:
Agentes autônomos são muito mais úteis quando eu consigo pilotá-los sem precisar microgerenciar cada decisão.
O modelo faz o trabalho. O Orca organiza a execução. A infraestrutura mantém cada agente dentro da estrada. E meu notebook finalmente pode voltar a ser só meu computador.