Data VênIA: IA, um hackathon e as decisões por trás do 9º lugar
Domingo, 16h23.
Faltavam sete minutos para começarem as apresentações da nossa categoria no Hackathon da OAB-PR. Eu e o Felipe estávamos corrigindo duas variáveis de ambiente que não tinham sido configuradas na Vercel de produção.
Sem elas, uma parte essencial da busca não funcionava como deveria. Às 16h30, precisávamos apresentar.
A investigação daquele problema tinha começado por volta das 12h30, quando uma busca aparentemente simples por “saúde” não retornava resultados. Nas quatro horas seguintes encontramos problemas de encoding, filtros que restringiam demais as consultas, configuração incompleta do ambiente e gargalos de desempenho.
Tudo isso existia em uma aplicação que, olhando o repositório, parecia ter avançado muito.
Terminamos o hackathon em 9º lugar. Tínhamos uma aplicação publicada, integração com o TJPR, análise de acórdãos e geração de relatório. Também tínhamos uma reescrita de frontend abandonada, dois reverts feitos de madrugada e partes importantes do fluxo sendo testadas pela primeira vez no domingo.
Foi por isso que resolvi escrever este postmortem.
Não para explicar por que ficamos em 9º mas para entender uma contradição que ficou muito clara depois do evento:
nunca foi tão rápido construir tanta coisa. Ainda assim, deixamos para descobrir tarde demais se algumas das coisas mais importantes realmente funcionavam juntas.
Eu já tinha errado em um hackathon antes
Em 2025, minha equipe nem chegou à apresentação final.
Naquela edição, focamos demais na solução. Gastamos energia construindo e deixamos pouco tempo para validar o problema, organizar a entrega e explicar por que alguém usaria aquilo.
Voltei em 2026 querendo corrigir esse erro. Em vários aspectos, corrigimos.
A nova equipe teve uma dinâmica muito melhor. Nathalia Gatt e Isabele Cristina traziam a perspectiva jurídica em conjunto com a Natally Barbosa que trabalhava no problema na narrativa de valor e liderança. Pamela Damazo cuidava da experiência visual, da apresentação dos dados e produziu o protótipo em HTML que depois serviria de referência para o frontend.
Na parte técnica, Felipe Bassetti ficou principalmente com a arquitetura e a integração com o TJPR. Eu trabalhei na interface, integrações e implantação.
Dessa vez, nós não começamos simplesmente procurando algo interessante para programar. O problema veio de quem precisava fazer a pesquisa.
A ideia veio da rotina de quem pesquisa jurisprudência
A ideia que escolhemos apareceu de forma muito mais simples.
Dentro da própria equipe, quem utilizava o portal de jurisprudência do TJPR descreveu a rotina: testar palavras diferentes, abrir resultados, ler decisões, separar o que realmente servia para o caso e depois conferir as fontes.
O problema não era simplesmente “encontrar documentos”. Imagine um advogado preparando um recurso.
Encontrar dez decisões contendo as mesmas palavras não significa que as dez tratem da mesma situação. Um mesmo acórdão pode sustentar determinado argumento e, ao mesmo tempo, trazer uma conclusão desfavorável sobre outro ponto. A pesquisa continuava exigindo leitura, comparação e verificação.
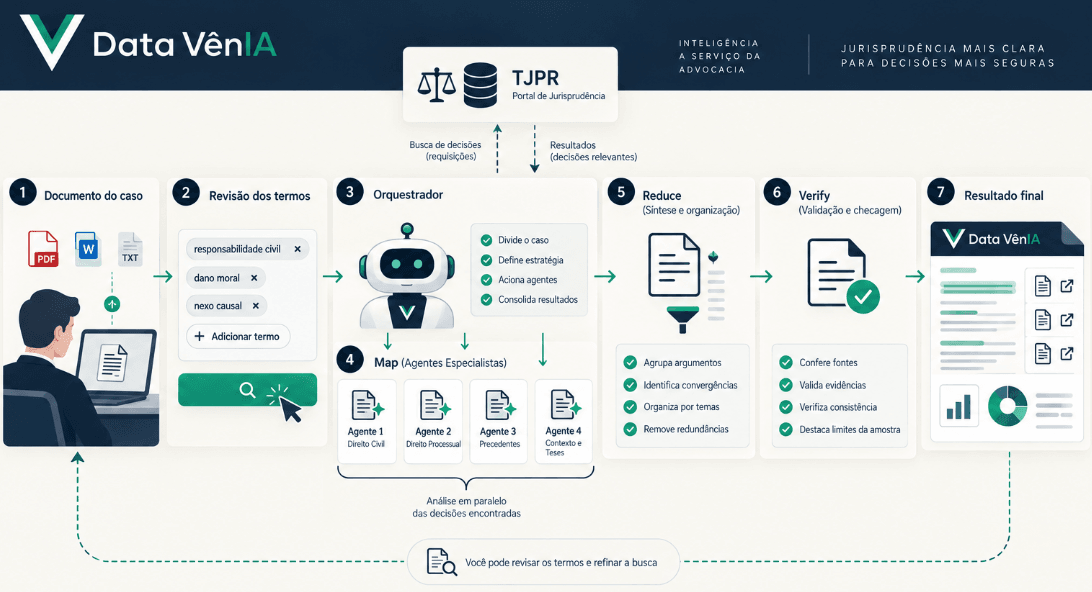
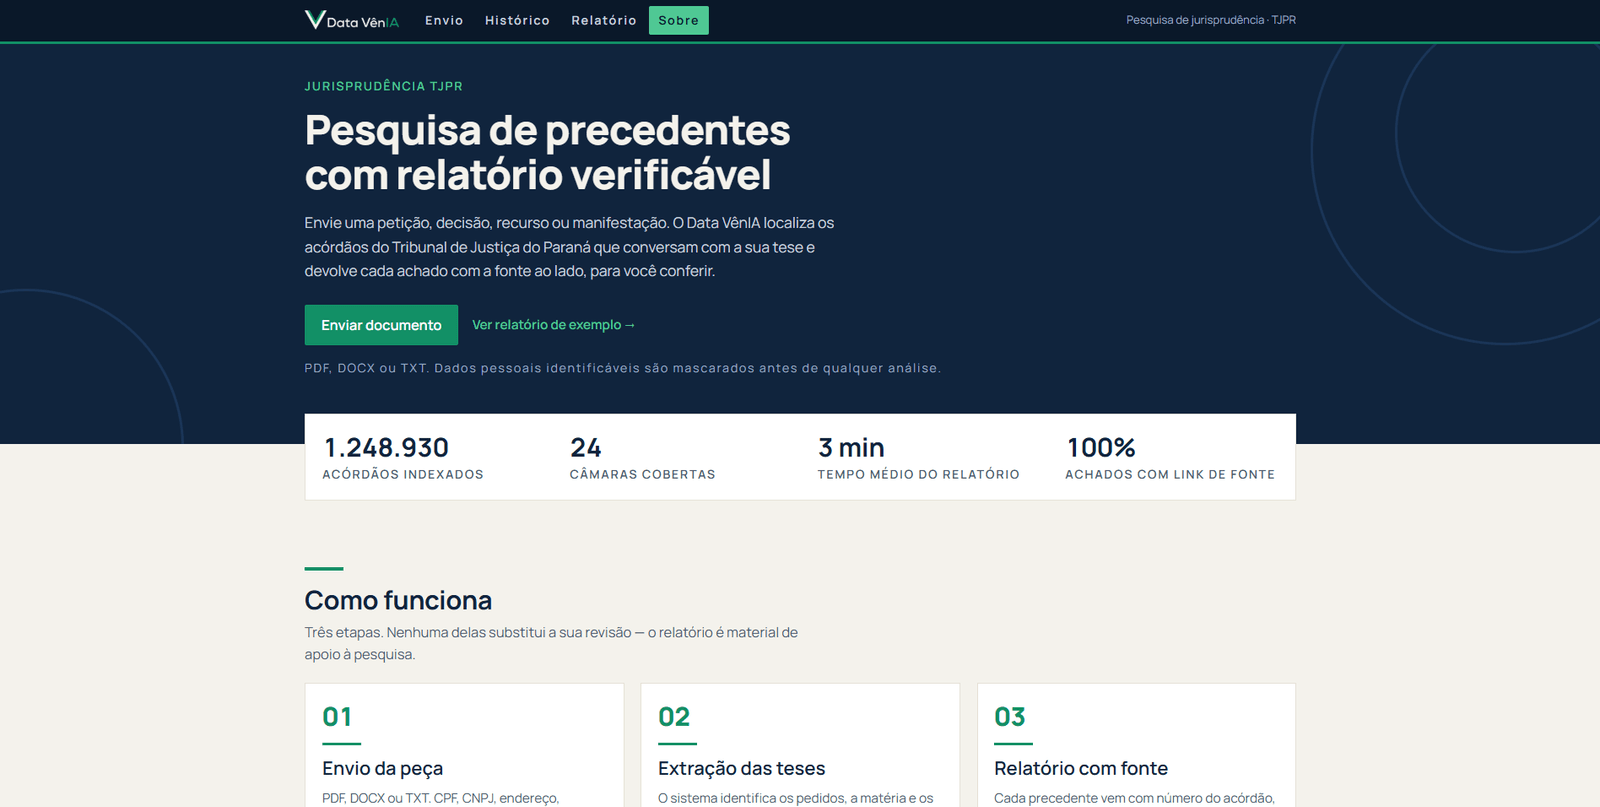
Foi daí que nasceu o Data VênIA.
O usuário enviaria um documento, revisaria os termos utilizados na busca e receberia uma análise das decisões encontradas. Cada conclusão deveria permitir voltar à decisão original e verificar a evidência.
A ferramenta não decidiria pelo advogado. Ela organizaria a pesquisa.
Toda a preparação que fiz antes do evento tinha produzido várias hipóteses. Essa conversa nos deu algo melhor: uma tarefa concreta.
Às 09h07 de sábado, o código já estava andando
O primeiro commit com a estrutura de várias etapas do processamento entrou às 09h07 de sábado.
Enquanto Felipe avançava no pipeline, eu preparava o ambiente, hospedagem e persistência. O repositório crescia muito rápido.
E isso produz uma sensação perigosa: a de que avanço de código e avanço de produto são a mesma coisa.
Nosso pipeline tinha uma estrutura interessante:
- Map: cada acórdão era analisado individualmente e transformado numa ficha estruturada.
- Reduce: essas fichas eram comparadas para encontrar aproximações, divergências e argumentos relevantes.
- Verify: antes de entrar no relatório, as citações deveriam ser conferidas novamente no texto original.
O princípio era importante: a IA poderia organizar a leitura, mas a fonte continuaria sendo o acórdão.
Para não bloquear o desenvolvimento enquanto investigávamos a integração com o TJPR, criamos uma fixture com decisões fictícias. Com ela, conseguíamos continuar desenvolvendo análise e relatório sem depender do portal real.
Tecnicamente, funcionou. Narrativamente, aqui começa o nosso problema.
A mentoria aumentou o produto
Depois da mentoria apareceram perguntas importantes.
- Quem pagaria pelas chamadas aos modelos?
- Por que um advogado utilizaria nossa ferramenta se já tivesse acesso a uma IA?
- Até onde deveríamos expandir a pesquisa para outros tribunais?
Falamos em apoio institucional e até na possibilidade de o usuário utilizar sua própria conta de IA. Nenhuma dessas alternativas estava resolvida. Para aquele fim de semana, o Paraná continuava sendo o recorte possível.
Mas a conversa também trouxe requisitos muito concretos.
- O advogado precisava revisar os termos de busca.
- Documentos poderiam conter dados pessoais ou sensíveis.
- As conclusões do relatório precisavam mostrar de onde vinham.
E os números do dashboard não poderiam parecer mais conclusivos do que realmente eram. Se analisamos nove decisões e seis seguem determinada direção, podemos mostrar “6 de 9 decisões na amostra analisada”. Transformar isso em “66% de chance de ganhar” seria outra afirmação completamente diferente.
Sábado, 15h54: eu comecei outra interface
Durante a tarde, já estávamos enfrentando problemas nas integrações com os modelos.
Em uma chamada à OpenAI, enviávamos max_tokens, enquanto o modelo esperava max_completion_tokens. Em outra situação, a requisição consumia tempo e tokens, mas não retornava o conteúdo esperado.
O pipeline demorava.
Então adicionamos indicação de progresso e um inspetor de execução. Eles ajudavam tanto o usuário a entender a espera quanto nós a investigar falhas.
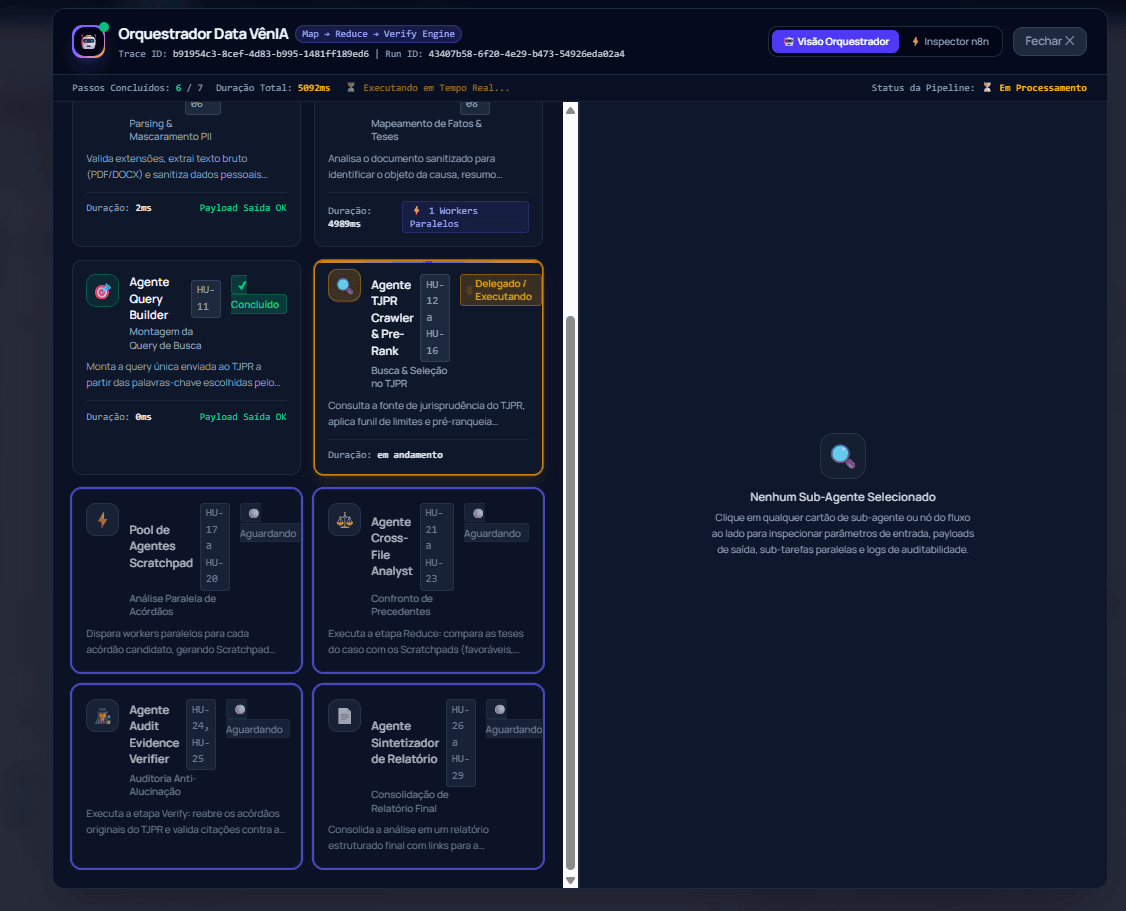
Ao mesmo tempo, a identidade visual estava pronta e o protótipo da Pamela mostrava uma interface muito melhor do que tínhamos naquele momento.
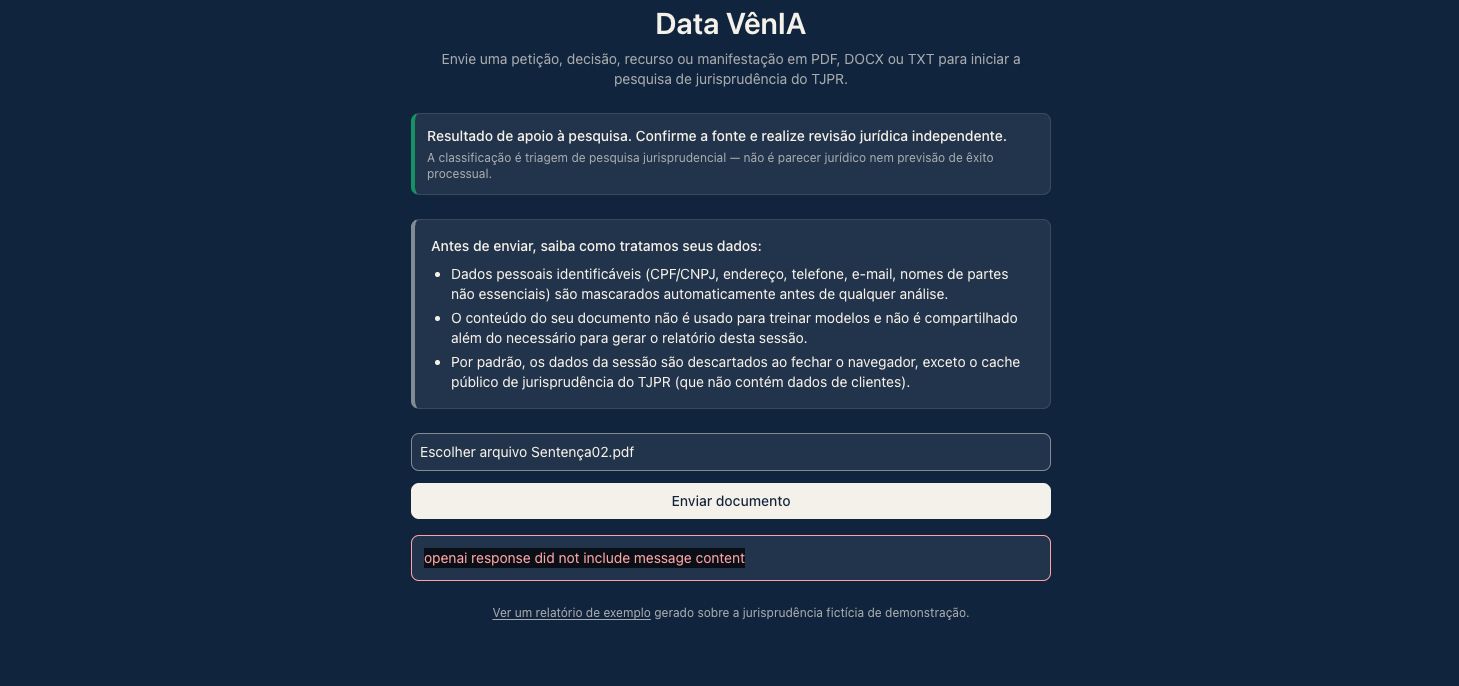
Melhorar o frontend fazia sentido. O horário, não. Às 15h54, comecei uma reescrita.
Nossa próxima entrega estava marcada para 17h30 e previa uma versão validada com testes externos. Eu tinha uma hora e trinta e seis minutos. Às 17h02, me perguntei como testar aquela mudança sem quebrar a auditória. Essa pergunta deveria ter vindo antes da primeira linha da reescrita.
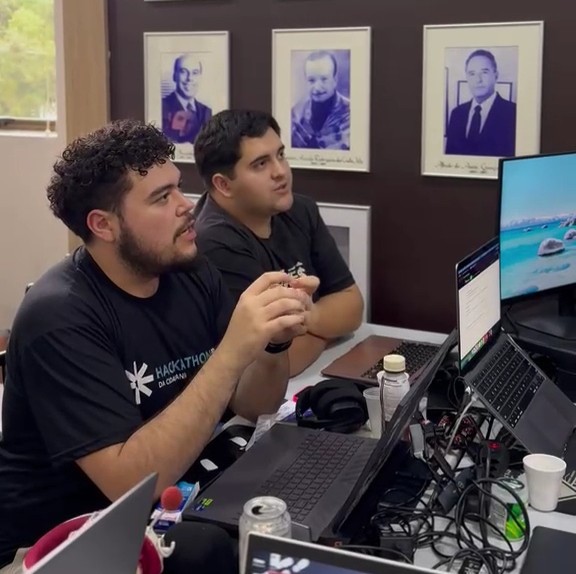
A IA tornava perfeitamente possível produzir uma quantidade enorme de interface dentro daquela janela. O que ela não eliminava era o restante do trabalho: integrar com o que outra pessoa estava desenvolvendo, resolver conflitos, testar o fluxo completo, publicar e verificar novamente.
A madrugada virou uma disputa por estabilidade
Boa parte da madrugada foi dedicada a transformar o protótipo da Pamela em uma interface conectada ao sistema real.
À 01h43 de domingo, abandonei o caminho que estava seguindo. Às 02h36 havia outro commit de redesign.
Esse limite mudou a forma de trabalhar. Em vez de reconstruir tudo, começamos a adaptar ao redor de algo conhecido.
Então voltou uma necessidade discutida desde a mentoria: permitir que o advogado revisasse os termos de busca. A primeira implementação dividia o processamento em duas partes e exigia uma pausa no fluxo.
Não era o que eu imaginava.
Às 04h02 entrou uma versão. Às 04h07, revert. Às 04h27 entrou outra. Às 04h31, outro revert.
Seria fácil olhar para isso e dizer que a IA complicou o pedido. Mas fui eu quem pediu uma mudança sem delimitar adequadamente quanto do fluxo poderia ser alterado.
A implementação ficou pronta tão rápido que a diferença entre o que eu pedi e o que realmente queria só ficou evidente quando usei a tela. Mais tarde chegamos a uma solução menor: sugerir termos sem transformar toda a execução.
No domingo, a realidade começou a entrar no sistema
Às 06h31 encontramos um problema na sanitização.
O nome de uma parte aparecia de uma forma que nossos exemplos não previam e escapava do tratamento.
Corrigimos. Depois vieram outros casos.
- Links que pareciam oficiais precisavam realmente apontar para a fonte correta.
- Filtros que faziam sentido para nós precisavam fazer sentido para quem estava testando.
Às 12h53, encontramos um PDF de quatro páginas do qual nosso extrator obtinha exatamente zero caracteres.
Adicionamos uma verificação para detectar o cenário e explicar a limitação antes de iniciar a análise. Implementar OCR naquele momento ficou fora do escopo.
Também descobrimos um problema no outro extremo do fluxo. O relatório exportado precisava permitir que o advogado selecionasse texto e clicasse nos links. Conseguimos gerar esse PDF localmente.
Na Vercel, ele falhou.
Os arquivos de fonte utilizados pelo gerador não tinham acompanhado o pacote de produção.
Entrada e saída estavam mostrando a mesma coisa para nós: testar uma parte isoladamente não significava testar o produto.
12h30: por que “saúde” não encontra nada?
Por volta das 12h30, eu e Felipe começamos a investigar a busca. Usamos “saúde”, um termo que deveria produzir resultados facilmente.
Nossa aplicação não encontrava nada.
- Não havia erro HTTP.
- Não havia exceção evidente.
- Ela simplesmente retornava uma lista vazia.
Às 14h41 entrou uma das correções.
Descobrimos que, na integração utilizada, o parâmetro da consulta era interpretado como ISO-8859-1. Nossa aplicação o enviava em UTF-8.
Mas “saúde” não era interpretado como “saúde”.
Esse bug tinha uma característica especialmente perigosa: uma falha técnica poderia ser apresentada ao advogado como uma conclusão sobre a realidade. Não parecia que a busca tinha falhado. Parecia que não existia jurisprudência.
Corrigimos o encoding. Então comparamos nossas consultas com buscas feitas diretamente no portal. Encontramos outro problema.
Alguns parâmetros adicionados durante os testes iniciais restringiam muito o conjunto de resultados. Depois de removê-los, determinadas pesquisas passaram a retornar volumes muito maiores.
Só não estava necessariamente fazendo a pesquisa que imaginávamos. Foi nesse momento que entendi melhor o limite da nossa fixture. Ela continuava sendo útil. O erro não foi criá-la.
O erro foi não colocá-la ao lado de consultas reais conhecidas, cujos resultados pudéssemos comparar continuamente com o portal.
16h23
Ainda havia um problema.
Durante toda aquela investigação, duas variáveis obrigatórias não estavam configuradas na Vercel de produção. Corrigimos às 16h23.
As apresentações começavam às 16h30.
Sete minutos.
O detalhe mais incômodo dessa história não é que esquecemos duas variáveis. Erros de configuração acontecem.
É que levamos boa parte da tarde para chegar a um ponto em que várias causas diferentes estavam finalmente separadas: comportamento da consulta, encoding, filtros, desempenho e ambiente.
Cada correção precisava ser implementada, publicada e testada enquanto a equipe também precisava entender qual versão apresentaria alguns minutos depois.
Nós conseguimos colocar a aplicação de pé.
Mas naquele momento ficou impossível ignorar quanto do nosso tempo tinha sido consumido não pela falta de capacidade de construir, mas pela falta de espaço para estabilizar o que já havíamos construído.
Então eu fui olhar os números
Depois do evento, fui levantar o volume de desenvolvimento. Os números são grandes.
No levantamento:
| Desenvolvedor | Commits | Adicionadas | Removidas | Alteração líquida |
|---|---|---|---|---|
| Emanuel Zaveruka | 37 | 20.167 | 5.284 | +14.883 |
| Felipe Bassetti | 44 | 41.391 | 8.110 | +33.281 |
| Total | 81 | 61.558 | 13.394 | +48.164 |
Também fui olhar separadamente o uso das ferramentas de IA. Mas, para mim, a parte interessante não está no tamanho do número. Está no que havia dentro dele.
Às 15h54 de sábado, começar outro frontend parecia razoável porque produzir aquele frontend rapidamente era possível.
O fato de ser possível construir não significava que havia tempo para integrar, validar, publicar e ensinar a equipe a operar aquela nova versão. Se tivesse um ambiente de testes para receber o feedback em tempo real seria o perfeito.
Essa é provavelmente a principal coisa que quero levar deste projeto.
O que eu faria diferente
Se começasse novamente, reduziria o problema até conseguir provar um único fluxo de ponta a ponta:
um documento real → uma busca conhecida no TJPR → poucas decisões → análise → evidências verificadas → relatório.
Antes de aumentar o volume ou adicionar novas funcionalidades, faria esse caminho funcionar de forma previsível em produção. Mediria tempo, custo e qualidade do resultado, e colocaria outra pessoa para percorrer o fluxo sem depender de quem o desenvolveu.
Manteria boa parte das decisões que tomamos: a análise de argumentos contrários, a verificação das citações, o cuidado com indicadores e a fixture para desenvolvimento. A diferença seria nunca deixar a fixture se tornar nossa principal referência de funcionamento. Ela existiria sempre ao lado de algumas consultas reais conhecidas, usadas como teste de regressão.
Também criaria um ponto claro de feature freeze. A partir dali, nenhuma nova ideia entraria. O foco passaria a ser configuração de produção, variáveis de ambiente, integrações externas, tempos de resposta, tratamento de falhas e o percurso completo que seria apresentado.
Isso provavelmente teria evitado parte do que aconteceu no domingo: tínhamos funcionalidades suficientes, mas ainda estávamos descobrindo problemas de produção poucas horas antes da apresentação.
Por fim, distribuiria melhor o conhecimento técnico. Felipe e eu trabalhávamos em partes complementares, mas algumas áreas do sistema ainda dependiam demais do contexto de quem as havia construído. Em um projeto tão curto, conseguir trocar de posição rapidamente durante um problema crítico vale quase tanto quanto desenvolver rápido.
O principal aprendizado seria esse: num hackathon, depois de certo ponto, entregar menos funcionalidades funcionando de forma previsível vale mais do que continuar aumentando o sistema.
E o 9º lugar?
Não sei dizer exatamente quais problemas custaram pontos. Mas sei o que mudou de 2025 para 2026.
Em 2025, saí com a sensação de que precisava melhorar a definição do problema, a organização da entrega e a apresentação.
Em 2026, o aprendizado foi outro:
velocidade de desenvolvimento também precisa ser administrada.
Não basta construir muitas funcionalidades. A equipe precisa chegar a uma versão que consiga conhecer, testar, estabilizar e apresentar com segurança.
Terminamos o hackathon com uma aplicação funcional, uma equipe que conseguiu construir junta e um problema que ainda vale investigar. O Data VênIA não está pronto — e hoje isso está muito mais claro.
O hackathon mostrou que conseguimos construir rápido. Agora precisamos provar que conseguimos transformar essa velocidade em um produto confiável.
O Data VênIA nasceu em um fim de semana. Agora começa a parte que não cabe em um hackathon.